Esta página se muestra en inglés hasta que haya una traducción completa.
Volver a AcademiaHistoria de la Inteligencia Artificial
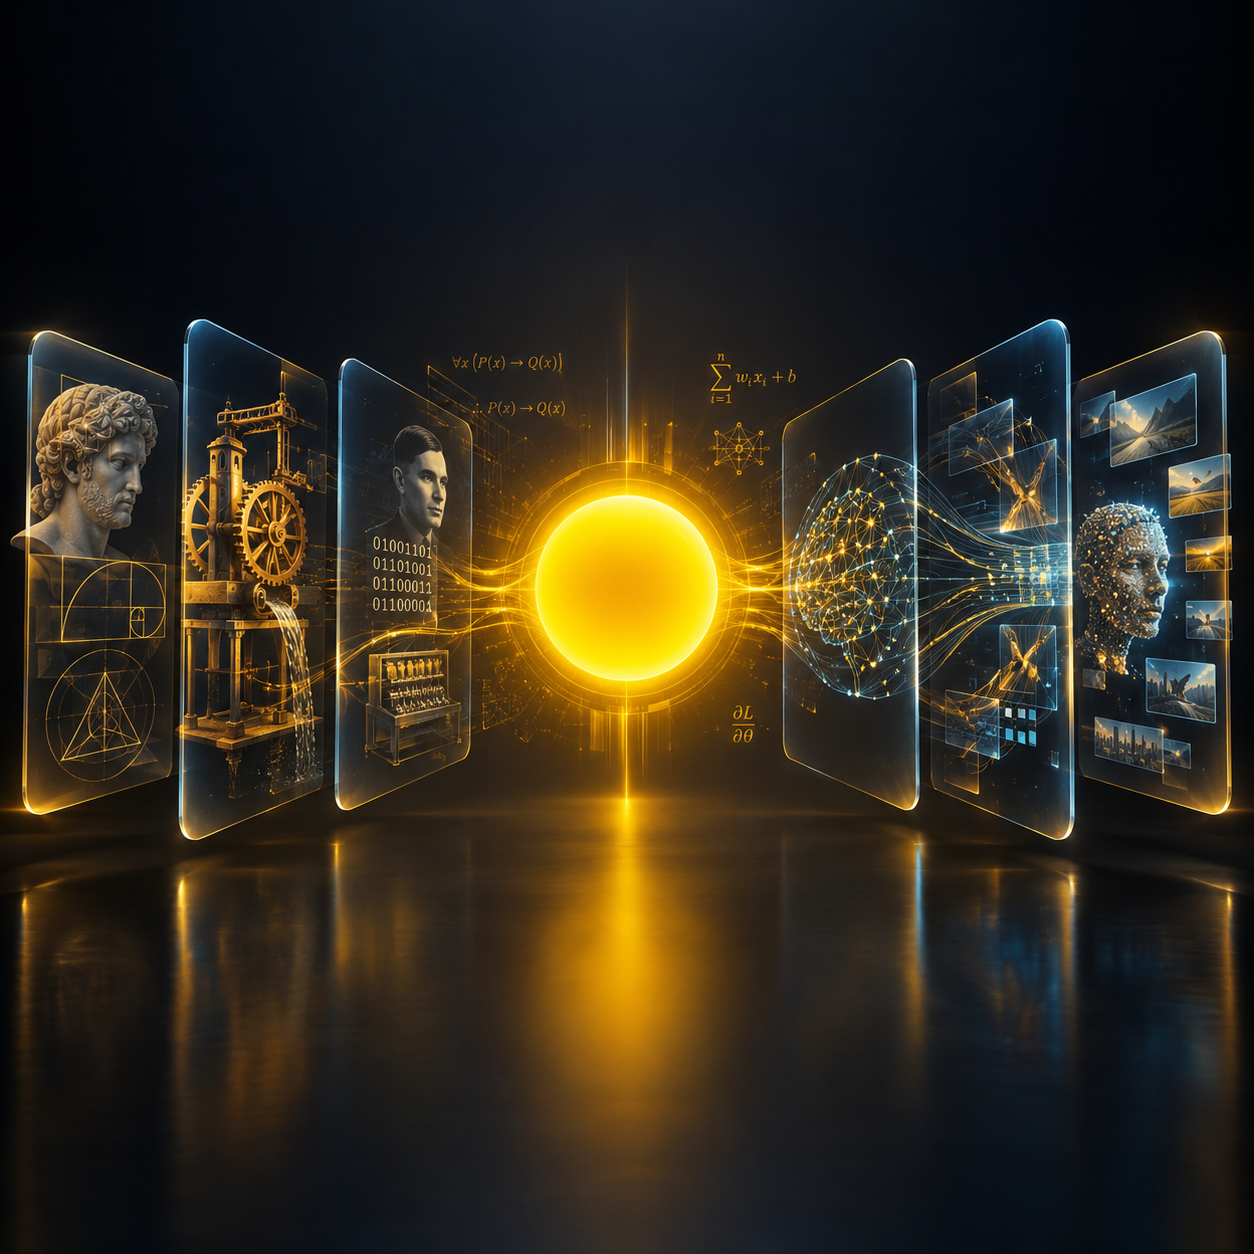
La idea de crear una máquina capaz de pensar y tomar decisiones al igual que un ser humano no comenzó con la llegada de las computadoras modernas; sus raíces se remontan a miles de años atrás. A lo largo de la historia de la humanidad, numerosos filósofos, pensadores y científicos han intentado responder a preguntas fundamentales como: "¿Cuál es la naturaleza de la inteligencia?" y "¿Es posible reproducir la inteligencia de forma artificial?". Estas cuestiones teóricas constituyeron la base conceptual que finalmente condujo al surgimiento de la Inteligencia Artificial (IA) como una disciplina científica independiente.
En la antigua Grecia, filósofos como Platón (Plato) y Aristóteles (Aristotle) otorgaron una importancia fundamental a la lógica, al pensamiento estructurado y a los métodos para alcanzar el conocimiento. En particular, Aristóteles desarrolló el primer sistema formal de lógica, estableciendo las reglas del razonamiento deductivo (el silogismo). Aunque estos primeros trabajos no condujeron directamente a la creación de una inteligencia artificial, sentaron el principio fundamental de que el pensamiento humano puede ser descrito de manera simbólica a través de reglas y principios definidos.
En la Edad Media y a comienzos de la Edad Moderna, matemáticos y filósofos buscaron desarrollar de manera sistemática la integración de la lógica y las matemáticas. En el siglo XVII, Gottfried Wilhelm Leibniz propuso un lenguaje simbólico universal para expresar la lógica y los conceptos (Characteristica universalis). Leibniz sostenía que si todos los pensamientos pudieran traducirse en leyes matemáticas, las futuras máquinas de calcular serían capaces de resolver problemas complejos mediante el cálculo. Aunque esta idea era irrealizable en su época, proporcionó un fundamento racionalista clave para la inteligencia artificial.
En el siglo XIX, se produjeron avances tecnológicos determinantes en el ámbito del cálculo y la automatización. Charles Babbage diseñó la "Máquina Analítica" (Analytical Engine), la cual incorporaba ya varias características esenciales de las computadoras modernas, como memoria (Memory), una unidad de procesamiento (ALU) y la capacidad de ser programada. Aunque esta máquina nunca llegó a construirse por completo, los historiadores de la ciencia la consideran el primer diseño de una computadora de propósito general.
En el mismo período, Ada Lovelace —considerada la primera programadora de la historia— realizó una observación extraordinariamente visionaria. Predijo que las futuras máquinas de calcular no se limitarían al procesamiento de números, sino que también serían capaces de manipular música, imágenes y diversos formatos de datos no estructurados. Esta intuición fue profundamente revolucionaria para su época y desempeñó más tarde un papel crucial en la ampliación de los horizontes de la inteligencia artificial.
A principios del siglo XX, el desarrollo de la lógica formalizada y de los fundamentos matemáticos se aceleró de forma considerable. Los trabajos de George Boole sobre el álgebra booleana, seguidos por las investigaciones de Gottlob Frege, Bertrand Russell y Alfred North Whitehead, proporcionaron una estructura rigurosa a la lógica matemática. Estas contribuciones demostraron que determinados patrones del pensamiento humano podían formularse mediante reglas formales y ser ejecutados por una máquina automática.
La ruptura paradigmática más trascendental de esta etapa surgió de los trabajos fundamentales de Alan Turing. En 1936, en su histórico artículo titulado On Computable Numbers, with an Application to the Entscheidungsproblem, Turing introdujo el modelo teórico de la "Máquina de Turing" (Turing Machine). Demostró matemáticamente que cualquier proceso lógico, siempre que pueda describirse con precisión mediante un algoritmo, puede ser ejecutado por una máquina de Turing universal. Este concepto teórico se convirtió en el pilar fundamental de la ciencia de la computación y de la inteligencia artificial.
Tras la Segunda Guerra Mundial, la aparición de las computadoras electrónicas ofreció el marco material necesario para la aplicación práctica de estas teorías. En 1950, Turing publicó en la revista filosófica Mind su célebre artículo Computing Machinery and Intelligence, planteando la histórica pregunta: "¿Pueden pensar las máquinas?" (Can machines think?). Asimismo, propuso un test práctico para evaluar el comportamiento inteligente de un sistema informático, método conocido hoy en día como el "Test de Turing" (Turing Test).
Todos estos avances —desde la lógica griega antigua y la filosofía matemática de Leibniz hasta la Máquina Analítica de Babbage, la visión computacional de Lovelace y las teorías de la computabilidad de Turing— proporcionaron el sólido cimiento científico e intelectual necesario para el nacimiento de la inteligencia artificial. Este recorrido culminó en 1956 con la Conferencia de Dartmouth (Dartmouth Conference), donde la inteligencia artificial fue declarada oficialmente como una disciplina científica independiente.
Al-Jazari y la ingeniería temprana de autómatas (Al-Jazari and Automata)
Siglos antes del nacimiento oficial de la inteligencia artificial, los intentos de construir dispositivos automáticos y sistemas autónomos sentaron una importante base práctica e ingenieril para el desarrollo posterior de la robótica y la ingeniería mecánica. Uno de los pioneros más destacados en este ámbito fue Badi al-Zaman Abu al-'Izz ibn Ismail ibn al-Razzaz al-Jazari (Ismail al-Jazari, 1136–1206 d. C.). Al-Jazari vivió en Amed (la actual Diyarbakır), en el norte del Kurdistán, y sirvió durante casi cincuenta años como ingeniero jefe en la corte de la dinastía Artúquida.
En 1206, al-Jazari completó su obra maestra de ingeniería, El libro del conocimiento de los ingeniosos dispositivos mecánicos (The Book of Knowledge of Ingenious Mechanical Devices). Este manuscrito es considerado uno de los documentos históricos más importantes de la ingeniería mecánica, en el cual describe en detalle cerca de 50 dispositivos mecánicos y autómatas, acompañados de explicaciones técnicas precisas e ilustraciones. Entre sus invenciones se encontraban complejos relojes de agua, bombas hidráulicas de doble efecto (Double-acting Pump), sirvientes automáticos, mecanismos de lavado de manos automático y conjuntos musicales mecánicos, los cuales funcionaban de forma autónoma sin intervención humana mediante mecánica de fluidos, gravedad y sistemas de levas (Cam Mechanism).
Muchos historiadores de la tecnología consideran a al-Jazari como uno de los padres de la ingeniería mecánica y de la teoría de control de automatización. Aunque las máquinas de al-Jazari no poseían inteligencia artificial en el sentido moderno —al carecer de capacidad de aprendizaje, toma de decisiones o adaptación autónoma—, sus innovaciones ingenieriles constituyen un hito histórico fundamental en la trayectoria hacia la construcción de autómatas humanoides y sistemas autónomos.
Alan Turing y el Test de Turing (Alan Turing and the Turing Test)
Alan Mathison Turing (1912–1954) es reconocido como uno de los fundadores esenciales de la ciencia de la computación y de la inteligencia artificial. Sus investigaciones no solo proporcionaron un marco teórico para la computación, sino que también inauguraron un nuevo paradigma para evaluar la capacidad de las máquinas al imitar la inteligencia humana. Además, Turing desempeñó un papel determinante durante la Segunda Guerra Mundial en el descifrado de la máquina alemana "Enigma", lo que influyó de manera decisiva en la victoria de los Aliados y en el desarrollo de las computadoras modernas.
El modelo de la Máquina de Turing y los fundamentos de la computabilidad
En 1936, Turing publicó su histórico artículo On Computable Numbers, with an Application to the Entscheidungsproblem, introduciendo el modelo matemático abstracto de la "Máquina de Turing".
No se trataba de un dispositivo físico, sino de una construcción matemática que demostraba cómo cualquier proceso lógico ordenado puede descomponerse en instrucciones discretas paso a paso. La trascendencia de este modelo residía en la demostración de la computabilidad algorítmica: cualquier problema que pueda ser descrito mediante un algoritmo es teóricamente resoluble por una máquina de Turing universal. Esta idea se convirtió en la piedra angular de toda la informática moderna.
"¿Pueden pensar las máquinas?"
En 1950, Turing publicó en la revista Mind su influyente artículo Computing Machinery and Intelligence, el cual comenzaba con la célebre interrogante:
«Can machines think?» ("¿Pueden pensar las máquinas?")
Turing sostenía que el término "pensar" era filosófica y semánticamente demasiado ambiguo. Por ello, propuso sustituir esta pregunta abstracta por una prueba conductual práctica orientada a evaluar el desempeño operativo de los sistemas informáticos.
El Test de Turing (The Turing Test)
Denominado originalmente como el "Juego de la Imitación" (Imitation Game), este test involucra a tres participantes principales:
Un participante humano (como punto de referencia);
Una computadora o sistema de IA (que intenta simular el comportamiento humano);
Un evaluador humano (juez) situado en una habitación separada, que decide en condiciones de prueba a ciegas.
El evaluador se comunica con ambas partes exclusivamente mediante el intercambio de mensajes de texto. Si al finalizar la prueba el evaluador no puede distinguir con certeza quién es la máquina y quién es el humano, se considera que el sistema de IA ha superado el test.
Nota académica: El propósito de este test no es demostrar que la máquina posee "conciencia" o "sentimientos", sino únicamente medir si su comportamiento lingüístico y conversacional alcanza un nivel equivalente al humano.
Impacto en la evolución de la Inteligencia Artificial
El Test de Turing se convirtió en uno de los estándares más influyentes en la historia de la inteligencia artificial. Proporcionó por primera vez un marco operacional para evaluar las capacidades de los sistemas inteligentes. Esta perspectiva orientó profundamente la investigación posterior a 1950, impulsando el desarrollo de agentes conversacionales (Chatbots), sistemas de preguntas y respuestas y los grandes modelos de lenguaje modernos (LLMs).
En el siglo XXI, con el advenimiento de los modelos de lenguaje avanzados, el debate en torno al Test de Turing ha cobrado nuevamente gran relevancia. Aunque algunos sistemas modernos muestran un comportamiento sorprendentemente humano en diálogos breves, existe consenso en la comunidad científica de que la sola superación del Test de Turing no constituye una prueba de la presencia de Inteligencia Artificial General (AGI) ni de conciencia, puesto que un sistema puede generar respuestas de apariencia humana mediante el reconocimiento estadístico de patrones sin poseer una comprensión real.
Críticas y limitaciones teóricas
A pesar de su peso histórico, el Test de Turing ha sido objeto de rigurosas críticas por parte de científicos y filósofos. Destaca John Searle, quien a través de su experimento mental de la "Habitación China" (Chinese Room), demostró que un sistema puede manipular símbolos siguiendo reglas puramente sintácticas (Syntax) sin poseer comprensión alguna del significado (Semantics). Asimismo, las ciencias cognitivas enfatizan que la inteligencia humana no se limita a la interacción verbal, sino que se halla profundamente vinculada a la percepción del entorno, la toma de decisiones y la interacción con el mundo real.
La Conferencia de Dartmouth y el nacimiento oficial de la IA (The Dartmouth Conference and the Formal Birth of AI)
La mayoría de los historiadores de la informática y la comunidad académica consideran el año 1956 como la fecha de nacimiento oficial de la Inteligencia Artificial (Artificial Intelligence, AI) como disciplina científica independiente. Durante el verano de ese año, se celebró un histórico seminario de investigación en el Dartmouth College, situado en el estado de New Hampshire (EE. UU.), evento conocido más tarde como el "Dartmouth Summer Research Project on Artificial Intelligence".
Esta conferencia constituyó el primer intento sistemático de establecer un campo de estudio independiente, dedicado exclusivamente a analizar los métodos para construir sistemas capaces de manifestar un comportamiento inteligente.
Orígenes del proyecto y pioneros (Origins and Pioneers)
La idea de esta conferencia fue propuesta originalmente por John McCarthy, quien más tarde sería reconocido como el "padre de la inteligencia artificial". Junto a él, otros pioneros participaron en la redacción de la propuesta de investigación: Marvin Minsky, Nathaniel Rochester de IBM y Claude Shannon, el fundador de la teoría de la información (Information Theory).
El texto de la propuesta contenía la siguiente hipótesis científica fundamental:
«Cada aspecto del aprendizaje o cualquier otra característica de la inteligencia puede, en principio, describirse con tanta precisión que se puede construir una máquina para simularlo exactamente.»
Esta afirmación se convirtió en un pilar intelectual central para los investigadores de la época, quienes estaban convencidos de que la inteligencia humana podía definirse mediante reglas, algoritmos y potencia de cálculo, para ser posteriormente ejecutada por una computadora.
El nacimiento del término "Artificial Intelligence" (Birth of the Term "Artificial Intelligence")
Uno de los resultados más trascendentales e históricos de la Conferencia de Dartmouth fue la introducción oficial, por parte de John McCarthy, del término "Artificial Intelligence" (Inteligencia Artificial) a nivel académico. Antes de esta fecha, las investigaciones en este ámbito se llevaban a cabo bajo diversas denominaciones como Cibernética (Cybernetics), Teoría de Autómatas (Automata Theory) o Procesamiento de Información Compleja (Complex Information Processing).
La elección de esta nueva denominación respondió a una razón estratégica: McCarthy deseaba diferenciar este campo de otras ciencias y dotarlo de una identidad académica propia. En este sentido, 1956 no marca únicamente la celebración de un congreso, sino el nacimiento institucional de una nueva disciplina científica.
Objetivos principales de la conferencia (Primary Objectives of the Conference)
Los investigadores congregados en Dartmouth preveían con un elevado optimismo que lograrían resolver los problemas principales de la inteligencia humana en cuestión de pocos años. Entre sus objetivos fundamentales se encontraban:
El desarrollo de sistemas de aprendizaje automático (Machine Learning);
La comprensión y procesamiento del lenguaje natural (Natural Language Processing, NLP);
La formalización de mecanismos de resolución de problemas y toma de decisiones;
El análisis formal del pensamiento lógico y abstracto;
El desarrollo de capacidades de reconocimiento de imágenes y objetos;
La construcción de una máquina capaz de exhibir un comportamiento rigurosamente equivalente al humano.
Aunque los investigadores creían en aquel momento que estos objetivos se alcanzarían en un futuro cercano, los acontecimientos posteriores demostraron que la inteligencia humana es de una complejidad y profundidad muy superiores a los modelos teóricos iniciales.
Impacto académico y apoyo institucional (Academic Impact and Institutional Support)
A pesar de que la Conferencia de Dartmouth no produjo inmediatamente un avance de ingeniería de gran escala, su impacto en la orientación de la ciencia de la computación fue monumental. Tras este acontecimiento, las universidades más prestigiosas del mundo comenzaron a crear laboratorios dedicados exclusivamente a la IA, entre ellas el Massachusetts Institute of Technology (MIT), la Universidad de Stanford y la Universidad Carnegie Mellon.
De forma paralela, el gobierno de los Estados Unidos y agencias federales como la DARPA asignaron importantes fondos de investigación para respaldar este ámbito emergente. Este apoyo financiero se convirtió en el motor principal para el desarrollo de los primeros programas inteligentes y para el progreso del aprendizaje automático.
Primeros avances pioneros: décadas de 1950 y 1960 (Early Breakthroughs: 1950s–1960s)
En la segunda mitad de la década de 1950 y a principios de la de 1960, surgieron varios proyectos fundacionales, entre los cuales destacan:
Logic Theorist (1956): Desarrollado por Allen Newell y Herbert A. Simon; considerado el primer programa de IA de la historia, capaz de demostrar teoremas de lógica simbólica.
General Problem Solver (GPS): Un intento pionero orientado a crear un sistema universal para la resolución de problemas lógicos.
El lenguaje de programación LISP (1958): Creado por el propio John McCarthy; se mantuvo durante décadas como el lenguaje fundamental para la investigación mundial en IA.
Estos logros, a pesar de sus limitaciones, demostraron que las computadoras podían ejecutar con éxito tareas de razonamiento lógico.
Los Inviernos de la IA (AI Winters)
Tras el prometedor inicio de la inteligencia artificial a finales de los años 50 y principios de los 60, numerosos investigadores e instituciones de financiación confiaban en que las computadoras asumirían la mayoría de las tareas intelectuales humanas en pocos años. Sin embargo, estas elevadas expectativas no se correspondían con las capacidades reales del hardware y la ingeniería de la época.
La profunda brecha entre las promesas y la realidad provocó caídas periódicas en la financiación, la confianza pública y la actividad investigadora. En la historia de la tecnología, estas fases de estancamiento se conocen como los "Inviernos de la IA" (AI Winters).
El término "Invierno de la IA" describe ciclos históricos en los cuales tanto el respaldo financiero como las expectativas del público cayeron drásticamente, debido a la incapacidad de los resultados prácticos para alcanzar el nivel de las ambiciosas predicciones formuladas por investigadores y empresas. Estos inviernos constituyeron puntos de inflexión cruciales en la historia de la IA, al obligar a la disciplina a reevaluar sus enfoques teóricos y sus metodologías.
El primer invierno de la IA: década de 1970 (The First AI Winter: 1970s)
El primer invierno de la disciplina comenzó a finales de la década de 1960 y principios de la de 1970. En ese período, aunque los primeros programas inteligentes como Logic Theorist, GPS y ELIZA habían captado la atención de los medios y del ámbito científico, sus capacidades eran extremadamente limitadas. La mayoría de estos sistemas solo funcionaban en entornos de laboratorio altamente simplificados y fracasaban ante la complejidad del mundo real.
El libro Perceptrons (1969): En este año, Marvin Minsky y Seymour Papert publicaron su célebre libro Perceptrons, en el que demostraron las limitaciones matemáticas de las redes neuronales artificiales monocapa. Aunque su crítica era científicamente rigurosa, muchos inversores la interpretaron como una prueba de que las redes neuronales carecían de futuro, lo que provocó la paralización de las investigaciones en este campo durante casi dos décadas.
El Informe Lighthill (1973): En 1973, el gobierno británico publicó un informe de evaluación estratégica titulado Lighthill Report. Redactado por el matemático Sir James Lighthill, el documento criticaba duramente las limitaciones de la IA y la falta de resultados prácticos significativos. Tras su publicación, se retiró la financiación a la mayoría de los proyectos de IA en el Reino Unido, generando un impacto negativo considerable a escala internacional.
El renacer de la esperanza: década de 1980 (The Revival of Hope: 1980s)
En la década de 1980, la inteligencia artificial volvió a captar el interés de empresas y gobiernos, impulsada principalmente por el éxito comercial de los Sistemas Expertos (Expert Systems). Estos sistemas codificaban el conocimiento y la experiencia de especialistas en un área determinada para aplicarlos a la toma de decisiones y a la resolución de problemas. Gigantes industriales como Digital Equipment Corporation (DEC) e IBM invirtieron sumas sustanciales en esta tecnología.
En el mismo período, el gobierno japonés lanzó su ambicioso proyecto nacional titulado "Sistemas Computacionales de Quinta Generación" (Fifth Generation Computer Systems, FGCS), cuyo objetivo era construir computadoras altamente inteligentes capaces de resolver problemas complejos. Estas iniciativas generaron una nueva ola de optimismo respecto al futuro de la inteligencia artificial.
El segundo invierno de la IA: finales de la década de 1980 y principios de la de 1990 (The Second AI Winter: Late 1980s–Early 1990s)
A pesar del optimismo inicial de los años 80, la inteligencia artificial volvió a chocar con un importante obstáculo técnico e ingenieril hacia finales de la década. Se puso de manifiesto que los Sistemas Expertos (Expert Systems) conllevaban costes de desarrollo y mantenimiento sumamente elevados, que la actualización de sus bases de conocimiento (Knowledge Base) era extremadamente compleja y que su capacidad de adaptación en entornos dinámicos y cambiantes seguía siendo muy limitada.
Esta situación se vio agravada por el crecimiento exponencial del mercado de las computadoras personales (PC). Muchas instituciones y empresas se orientaron hacia soluciones de hardware y software más económicas y versátiles, que no requerían el uso de equipos informáticos especializados y costosos. Como consecuencia, numerosas empresas del sector de la IA entraron en quiebra y la financiación para la investigación se redujo drásticamente una vez más. Este período quedó registrado en la historia de la tecnología como el "segundo invierno de la IA".
Causas principales del surgimiento de los inviernos de la IA (Key Causes of AI Winters)
Una serie de factores estructurales y sistémicos contribuyeron al desencadenamiento de estas fases de estancamiento:
Predicciones sobrevaloradas u optimismo desmedido: La afirmación apresurada de que se alcanzaría una Inteligencia Artificial General (AGI) equivalente a la humana en muy corto plazo.
Límites físicos de la capacidad de procesamiento: La escasa velocidad de cálculo y la memoria reducida de las computadoras de la época frente a las exigencias de las tareas cognitivas complejas.
Falta de conjuntos de datos adecuados: La ausencia de datos voluminosos y estructurados de alta calidad necesarios para entrenar los modelos.
Límites teóricos de los primeros algoritmos: La falta de algoritmos avanzados capaces de extraer automáticamente características abstractas de alto nivel.
Brecha entre el entorno de laboratorio y el mundo real: La profunda discrepancia entre el rendimiento de los sistemas en marcos experimentales controlados y su inestabilidad ante la complejidad del mundo real.
Desilusión de los inversores: El recorte drástico de los presupuestos de investigación por parte de gobiernos y del sector privado tras el incumplimiento de las promesas iniciales.
El auge del aprendizaje automático (The Rise of Machine Learning)
Tras las crisis sucesivas de los inviernos de la IA, los investigadores comprendieron que el enfoque clásico dominante en sus inicios —basado fundamentalmente en sistemas basados en reglas (Rule-Based Systems) redactados manualmente por expertos humanos— presentaba límites teóricos insuperables sin un cambio de paradigma. Para la mayoría de los fenómenos del mundo real, resultaba imposible codificar de manera exhaustiva el conjunto de reglas e hipótesis, ya que los contextos y los flujos de datos se hallaban en perpetua evolución.
De este modo surgió un nuevo paradigma revolucionario en la investigación: el aprendizaje automático (Machine Learning, ML). En este nuevo enfoque, las computadoras ya no aguardan instrucciones explícitas y rígidas, sino que aprenden directamente a partir de los datos para identificar patrones (patterns), extraer estructuras y ejecutar tareas de forma autónoma.
Avances en hardware y salto en la potencia de cálculo (Hardware Advances)
El desarrollo del aprendizaje automático no dependió únicamente de la formulación de nuevos algoritmos; los avances tecnológicos en hardware desempeñaron un papel catalizador determinante. Durante la década de 1990 y principios de la de 2000, las innovaciones arquitectónicas introducidas en las unidades centrales de procesamiento (CPU) por gigantes de los semiconductores como Intel y AMD incrementaron de forma exponencial la velocidad de cálculo de las computadoras. Este avance permitió probar modelos estadísticos más complejos y analizar volúmenes de datos considerablemente mayores.
Concepto y definición del aprendizaje automático (Concept and Definition of Machine Learning)
El aprendizaje automático es una rama fundamental de la inteligencia artificial cuyo objetivo es diseñar software y algoritmos capaces de aprender automáticamente a partir de los datos, detectar estructuras ocultas y formular predicciones o decisiones precisas, sin que el programador tenga que especificar manualmente cada regla.
Una de las definiciones más clásicas y reconocidas fue formulada en 1959 por el pionero Arthur Samuel:
«El aprendizaje automático es el campo de estudio que otorga a las computadoras la capacidad de aprender sin ser explícitamente programadas.»
Factores clave para la adopción del aprendizaje automático (Drivers of Machine Learning Adoption)
A finales de la década de 1980 y a lo largo de los años 90, varias transformaciones fundamentales aceleraron el despliegue del aprendizaje automático:
La explosión de la información digital: La constitución de los primeros grandes conjuntos de datos estandarizados (Datasets).
El incremento de la capacidad del hardware: El aumento de las velocidades de procesamiento y la reducción continua de los costes de almacenamiento de datos.
Progresos en las ciencias fundamentales: La integración de la estadística matemática, la teoría de la probabilidad (Probability Theory) y las teorías de optimización en la ciencia informática.
Exigencias del mercado y la industria: La fuerte demanda comercial de las empresas para contar con sistemas de predicción, clasificación de datos y reconocimiento de imagen y voz.
Estos factores impulsaron a los investigadores a abandonar la redacción de miles de líneas de reglas rígidas en favor de modelos estadísticos flexibles, capaces de encontrar por sí mismos la solución óptima en el seno de los datos.
Los tres grandes paradigmas del aprendizaje automático (Major Paradigms of Machine Learning)
Las técnicas de aprendizaje automático se dividen principalmente en tres grandes paradigmas a nivel teórico y práctico:
Aprendizaje supervisado (Supervised Learning): El modelo se entrena sobre un conjunto de datos que contiene etiquetas o respuestas objetivo explícitas (Labels). El objetivo principal es aprender la función de mapeo entre las características de entrada y las etiquetas de salida para realizar predicciones exactas sobre datos nuevos no observados.
Aplicaciones típicas: Estimación de precios inmobiliarios, filtrado de correo no deseado (spam) y diagnóstico médico a partir de imágenes.
Aprendizaje no supervisado (Unsupervised Learning): Los datos proporcionados al modelo carecen de etiquetas o respuestas predefinidas. El algoritmo busca descubrir por sí mismo la estructura subyacente, los agrupamientos naturales (Clusters) y las relaciones internas en los datos.
Aplicaciones típicas: Segmentación de clientes según su comportamiento (Customer Segmentation), detección de anomalías y fraudes (Anomaly Detection) y reducción de dimensionalidad de datos complejos.
Aprendizaje por refuerzo (Reinforcement Learning): En este método, un agente (Agent) aprende mediante ensayo y error (Trial and Error) en un entorno dinámico. Recibe una recompensa (Reward) por cada acción correcta y una penalización (Penalty) por cada error. Con el tiempo, el agente elabora una estrategia conductual óptima orientada a maximizar la recompensa acumulada.
Aplicaciones típicas: Toma de decisiones en juegos complejos (Ajedrez, Go), control de sistemas robóticos, vehículos autónomos y gestión automatizada de redes.
Evolución algorítmica y resurgimiento de las redes neuronales (Algorithmic Evolution and Resurgence of Neural Networks)
Durante las décadas de 1990 y 2000, maduraron diversos algoritmos estadísticos avanzados que sentaron las bases del aprendizaje automático moderno; entre ellos destacan los árboles de decisión (Decision Trees), los bosques aleatorios (Random Forests), las máquinas de vectores de soporte (Support Vector Machines, SVM), el clasificador Naïve Bayes y los k-vecinos más cercanos (k-Nearest Neighbors, k-NN). Estos métodos obtuvieron grandes éxitos prácticos en ámbitos como la economía, la medicina y el procesamiento del lenguaje natural.
Paralelamente, aunque las redes neuronales artificiales habían quedado relegadas tras el primer invierno de la IA, las investigaciones continuas llevadas a cabo por científicos como Geoffrey Hinton, David Rumelhart y Ronald Williams en los años 80 y 90 sobre el algoritmo de retropropagación del error (Backpropagation) atrajeron de nuevo la atención de la comunidad científica. La retropropagación proporcionó un método matemático altamente eficiente para entrenar redes neuronales multicapa, convirtiéndose más tarde en la piedra angular de la revolución del aprendizaje profundo (Deep Learning).
El concepto de "Big Data" y el auge de los procesadores GPU (Big Data and GPU Acceleration)
A principios del siglo XXI, con la generalización de Internet, las redes sociales, los teléfonos inteligentes y los servicios digitales, la cantidad de datos generados a escala mundial alcanzó un nivel sin precedentes, dando lugar al fenómeno del Big Data (Big Data).
Puesto que la precisión y la capacidad de los modelos de aprendizaje automático dependen directamente de su alimentación con datos voluminosos y de alta calidad, la llegada del Big Data se convirtió en el combustible esencial para el éxito de este campo. De forma paralela, el traslado de la carga de cálculo desde las unidades centrales (CPU) hacia los procesadores gráficos (GPU) y el desarrollo de técnicas de computación paralela (Parallel Computing) permitieron reducir el tiempo de entrenamiento de modelos gigantescos de varios meses a pocos días o incluso horas.
Impacto estratégico del aprendizaje automático en el futuro de la tecnología (Strategic Impact of ML)
El auge del aprendizaje automático transformó profundamente la orientación y la filosofía de la investigación en IA. Esta mutación teórica y práctica está en el origen del éxito de numerosas tecnologías que utilizamos diariamente en la actualidad; entre ellas:
Sistemas de recomendación personalizados: Los algoritmos de análisis de preferencias de usuarios en plataformas como Netflix y Spotify;
Traducción lingüística en tiempo real: Los sistemas multilingües de procesamiento del lenguaje natural;
Reconocimiento de voz y visión artificial: La visión por computadora y las tecnologías de verificación biométrica;
Salud digital y medicina: Los análisis clínicos para el diagnóstico precoz de enfermedades;
Inteligencia de negocios y ciberseguridad: El análisis automático de riesgos y el filtrado de correo no deseado.
Por encima de todo, el aprendizaje automático sirvió como un puente fundamental que hizo posible el surgimiento del aprendizaje profundo (Deep Learning) y de la IA Generativa (Generative AI), las cuales se hallan hoy en día en la cumbre de la innovación tecnológica mundial.
La revolución del aprendizaje profundo: El mayor cambio de paradigma de la IA (The Deep Learning Revolution)
El aprendizaje profundo (Deep Learning) es considerado uno de los puntos de inflexión más trascendentales y transformadores en la historia de la inteligencia artificial. Aunque los fundamentos teóricos de las redes neuronales artificiales (ANNs) se establecieron en las décadas de 1940 y 1950, la insuficiencia del hardware, la falta de datos y la complejidad matemática del entrenamiento de redes profundas frenaron el progreso durante décadas.
A principios del siglo XXI, tres factores fundamentales experimentaron una convergencia histórica: la explosión sin precedentes de los datos digitales (Big Data), la potencia de cálculo paralelo de las tarjetas gráficas (GPUs) y la formulación de nuevos algoritmos de entrenamiento. La combinación de estos tres elementos convirtió al aprendizaje profundo en el motor principal del avance global en IA.
Cambio de paradigma en el hardware: La transición de la CPU a la GPU
Una de las claves de ingeniería decisivas de la revolución del aprendizaje profundo fue la transferencia de la carga de cálculo desde las unidades centrales (CPU) hacia los procesadores gráficos (GPU). Las tarjetas GPU se diseñaron originalmente para videojuegos en 3D y renderizado gráfico; sin embargo, los investigadores descubrieron que estas tarjetas podían ejecutar miles de operaciones matriciales matemáticas de forma simultánea y paralela —precisamente lo que exigía el entrenamiento de redes neuronales profundas.
La empresa NVIDIA dio un paso revolucionario en 2006 con el lanzamiento de la arquitectura CUDA. Esta plataforma permitió a los investigadores aprovechar directamente la potencia de las tarjetas GPU para cálculos científicos intensivos y modelos de IA. Esta ruptura tecnológica sentó las bases para el éxito histórico del modelo AlexNet en 2012 y el inicio oficial de la revolución del aprendizaje profundo.
Principios y arquitectura del aprendizaje profundo (Principles and Architecture of Deep Learning)
El aprendizaje profundo es una rama avanzada del aprendizaje automático basada en redes neuronales profundas (Deep Neural Networks, DNNs). Estas redes están compuestas por una multitud de capas ocultas (Hidden Layers), donde cada capa aprende un nuevo nivel de abstracción de las características a partir de los datos.
Por ejemplo, en un sistema de visión por computadora dedicado al reconocimiento de objetos:
Las primeras capas: Detectan únicamente bordes, líneas y formas geométricas básicas;
Las capas intermedias: Combinan formas y texturas más complejas;
Las capas superiores: Realizan la representación global de los objetos (como un rostro humano o un vehículo).
La diferencia metodológica fundamental entre el aprendizaje automático clásico y el aprendizaje profundo reside en este principio:
El enfoque clásico: Exigía que expertos humanos definieran y extrajeran manualmente las características (Features) de los datos;
El enfoque del aprendizaje profundo: Funciona bajo el principio del aprendizaje de extremo a extremo (End-to-End); es decir, el modelo aprende y extrae sus características jerárquicas de forma totalmente autónoma directamente a partir de los datos brutos (Raw Data).
Fue esta capacidad superior de aprendizaje de representaciones la que permitió al aprendizaje profundo obtener éxitos prácticos sin precedentes en ámbitos complejos como la visión por computadora, el reconocimiento de voz y el procesamiento del lenguaje natural.
El potente resurgimiento de las redes neuronales (Resurgence of Neural Networks)
En la década de 1980, científicos como Geoffrey Hinton, David Rumelhart y Ronald Williams desarrollaron y popularizaron el algoritmo de retropropagación del error (Backpropagation). Este método ofreció un procedimiento matemático altamente eficiente para entrenar redes neuronales multicapa. Sin embargo, la velocidad de cálculo de las computadoras y el volumen de datos disponibles en aquella época resultaban aún insuficientes para hacer funcionar de forma eficaz redes excesivamente grandes en la práctica.
En la década de 2000, con el incremento de la capacidad de procesamiento de las tarjetas GPU y la disponibilidad de vastos conjuntos de datos en Internet, los investigadores volvieron a orientarse hacia este enfoque. De este modo, los parámetros de las redes neuronales profundas pudieron ser entrenados con éxito, sentando las bases sólidas de la revolución del aprendizaje profundo (Deep Learning).
El proyecto ImageNet: El hito histórico de 2012 (The ImageNet Landmark: 2012)
La mayoría de los historiadores de la IA consideran el año 2012 como el punto de partida oficial de la revolución del aprendizaje profundo. Ese año, Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton diseñaron una red neuronal convolucional profunda denominada AlexNet y participaron en la competición internacional ImageNet.
AlexNet empleó la arquitectura de las redes neuronales convolucionales (Convolutional Neural Network – CNN) junto con la potencia de procesamiento paralelo de las tarjetas GPU para reducir de manera espectacular la tasa de error en el reconocimiento de imágenes. El modelo superó a todos sus competidores basados en métodos tradicionales por un margen considerable. Este éxito histórico demostró que el aprendizaje profundo era enormemente superior a los enfoques clásicos ante problemas complejos del mundo real; en consecuencia, universidades de todo el mundo, gigantes tecnológicos e inversores destinaron capitales masivos a este campo.
Arquitectura y evolución de los modelos de aprendizaje profundo (Evolution of Deep Learning Architectures)
Tras el gran éxito de AlexNet, emergieron diversas arquitecturas de redes neuronales especializadas, cada una de las cuales desencadenó revoluciones en ámbitos específicos:
Las redes neuronales convolucionales (CNN): Diseñadas especialmente para la visión por computadora, el reconocimiento de objetos, el análisis de video y la imagen médica.
Las redes neuronales recurrentes (RNN): Utilizadas para el procesamiento de datos secuenciales (Sequential) como texto, habla y series temporales.
Las redes LSTM (Long Short-Term Memory): Desarrolladas para procesar de forma óptima secuencias largas de información y frases sin perder el contexto inicial.
Las redes Transformers (Transformer Networks): Presentadas en 2017 por Google; introdujeron el mecanismo de autoatención (Self-Attention). Esta arquitectura constituye la piedra angular de los Grandes Modelos de Lenguaje (LLMs) y de la IA Generativa (Generative AI) actuales.
Impactos prácticos y sociales del aprendizaje profundo (Practical Impact of Deep Learning)
El aprendizaje profundo ha generado transformaciones fundamentales en sectores críticos y estratégicos:
Visión por computadora: Reconocimiento facial en teléfonos inteligentes, análisis de imágenes médicas (rayos X, resonancia magnética) y conducción de vehículos autónomos.
Procesamiento del lenguaje natural: Traducción multilingüe en tiempo real, síntesis automática de textos extensos y agentes conversacionales inteligentes (como ChatGPT).
Reconocimiento de voz: Funcionamiento de asistentes de voz inteligentes y tecnologías de conversión de habla a texto.
Salud y biomedicina: Diagnóstico precoz del cáncer, análisis de datos genómicos (ADN) y descubrimiento de nuevas moléculas farmacológicas.
Industria y comercio: Predicción de la demanda del mercado, control de calidad automatizado y recomendaciones personalizadas de productos.
Limitaciones y desafíos del aprendizaje profundo (Limitations and Challenges)
A pesar de todos estos grandes éxitos, el aprendizaje profundo presenta limitaciones críticas:
Alta dependencia de los datos y elevados costes computacionales: El entrenamiento de estos modelos requiere volúmenes masivos de datos e infraestructuras de hardware extremadamente costosas y con un alto consumo energético.
El problema de la "caja negra" (Black Box Problem): La mayoría de los modelos profundos carecen de transparencia debido a su complejidad no lineal interna. El modelo proporciona una respuesta exacta, pero la lógica interna que subyace a esa decisión resulta sumamente difícil de explicar. Esto plantea importantes retos de confianza y responsabilidad en ámbitos vitales como la medicina, el derecho y las finanzas.
La IA Generativa (Generative AI) y ChatGPT: La nueva era de la creación de contenido
A finales de la década de 2010 y principios de la de 2020, la inteligencia artificial entró en una fase completamente nueva conocida como IA Generativa (Generative AI). La diferencia fundamental entre este período y las épocas anteriores radica en que los sistemas ya no son meras herramientas de análisis o clasificación de datos, sino que pueden producir por sí mismos contenidos totalmente nuevos u originales, como texto, imagen, audio, video y código informático.
¿Qué es la IA Generativa? (What is Generative AI?)
La IA Generativa es una rama avanzada de la inteligencia artificial en la cual los modelos son entrenados para comprender patrones, distribuciones de probabilidad y relaciones ocultas en vastos conjuntos de datos. Sobre la base de este aprendizaje, generan nuevos contenidos en respuesta a instrucciones de entrada (Prompts).
Infraestructura de hardware y el salto de los Grandes Modelos de Lenguaje (LLMs)
El desarrollo de los grandes modelos de lenguaje y de la IA generativa habría sido imposible sin avances revolucionarios en el hardware informático. El entrenamiento de estos modelos gigantescos exige miles de tarjetas GPU de alto rendimiento funcionando en paralelo.
En la actualidad, los procesadores avanzados de la compañía NVIDIA (como los modelos A100 y H100) se consideran la columna vertebral de la infraestructura global de IA. La arquitectura CUDA de la empresa permitió a los investigadores aprovechar plenamente la potencia de las GPU para cálculos científicos intensivos y modelos de IA.
El auge y las capacidades de los Grandes Modelos de Lenguaje (Large Language Models – LLM)
Sobre la base de la arquitectura Transformer se desarrollaron los Grandes Modelos de Lenguaje (LLM). Estos modelos se entrenan con cientos de miles de millones de palabras y textos, lo que les otorga la capacidad de captar los contextos complejos del lenguaje natural y los pensamientos humanos abstractos.
Los Grandes Modelos de Lenguaje pueden realizar con éxito las siguientes tareas:
Responder de manera lógica a preguntas complejas;
Redactar nuevos textos y sintetizar documentos extensos;
Traducir de forma fluida y automática entre diferentes idiomas;
Escribir, depurar (Debugging) y explicar código informático;
Corregir errores gramaticales y semánticos;
Asistir a los seres humanos en la investigación científica y en la resolución de problemas complejos.
El modelo ChatGPT: Una nueva era en el diálogo hombre-máquina
ChatGPT es la aplicación de IA generativa más famosa y ampliamente utilizada en el mundo. Desarrollado por OpenAI, este sistema se basa en la serie de modelos GPT (Generative Pre-trained Transformer).
Cuando se lanzó la primera versión pública de ChatGPT el 30 de noviembre de 2022, atrajo a millones de usuarios en todo el mundo en cuestión de pocos días. Este éxito demostró que la humanidad estaba preparada para adoptar la inteligencia artificial como una herramienta cotidiana para aprender, redactar, programar y traducir.
El secreto del éxito de ChatGPT: Además del preentrenamiento (Pre-training) sobre inmensos volúmenes de datos, el modelo utiliza la técnica del aprendizaje por refuerzo a partir de la retroalimentación humana (Reinforcement Learning from Human Feedback – RLHF). Esta técnica ha permitido que las respuestas sean extremadamente precisas, estructuradas y adaptadas al estilo natural de la conversación humana.
Aplicaciones multidisciplinares de la IA Generativa (Applications of Generative AI)
La IA Generativa ha transformado profundamente sectores clave:
Educación: Redacción de resúmenes de lecciones, explicación de conceptos científicos complejos y función de tutor personalizado.
Salud: Asistencia a los médicos en la redacción de informes clínicos y en el análisis de datos de pacientes.
Ingeniería de software: Ayuda a los desarrolladores en la escritura de código, depuración y explicación de arquitecturas de software.
Medios digitales: Redacción de borradores de noticias, creación de contenido y arte digital.
Comercio y marketing: Redacción de textos publicitarios, automatización del servicio al cliente y análisis de estrategias de mercado.
Arte y diseño: Generación de imágenes creativas, música, videos y diseños visuales.
Bibliografía académica (Academic Bibliography)
Russell, S., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, 2(42), 230–265.
Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433–460.
McCorduck, P. (2004). Machines Who Think: A Personal Inquiry into the History and Prospects of Artificial Intelligence (2nd ed.). A K Peters.
Nilsson, N. J. (2010). The Quest for Artificial Intelligence: A History of Ideas and Achievements. Cambridge University Press.
al-Jazarī, I. (1974). The Book of Knowledge of Ingenious Mechanical Devices (D. R. Hill, Trans.). D. Reidel Publishing Company.
Hill, D. R. (1998). Mechanical Engineering in the Medieval Near East. Scientific American, 264(5), 100–105.
Hill, D. R. (1991). Islamic Science and Engineering. Edinburgh University Press.
Encyclopaedia Britannica. al-Jazari.
Ceccarelli, M. (2004). Distinguished Figures in Mechanism and Machine Science. Springer.