تا آماده شدن ترجمهٔ کامل، این صفحه به انگلیسی نمایش داده میشود.
بازگشت به آکادمیکتاریخچه هوش مصنوعی
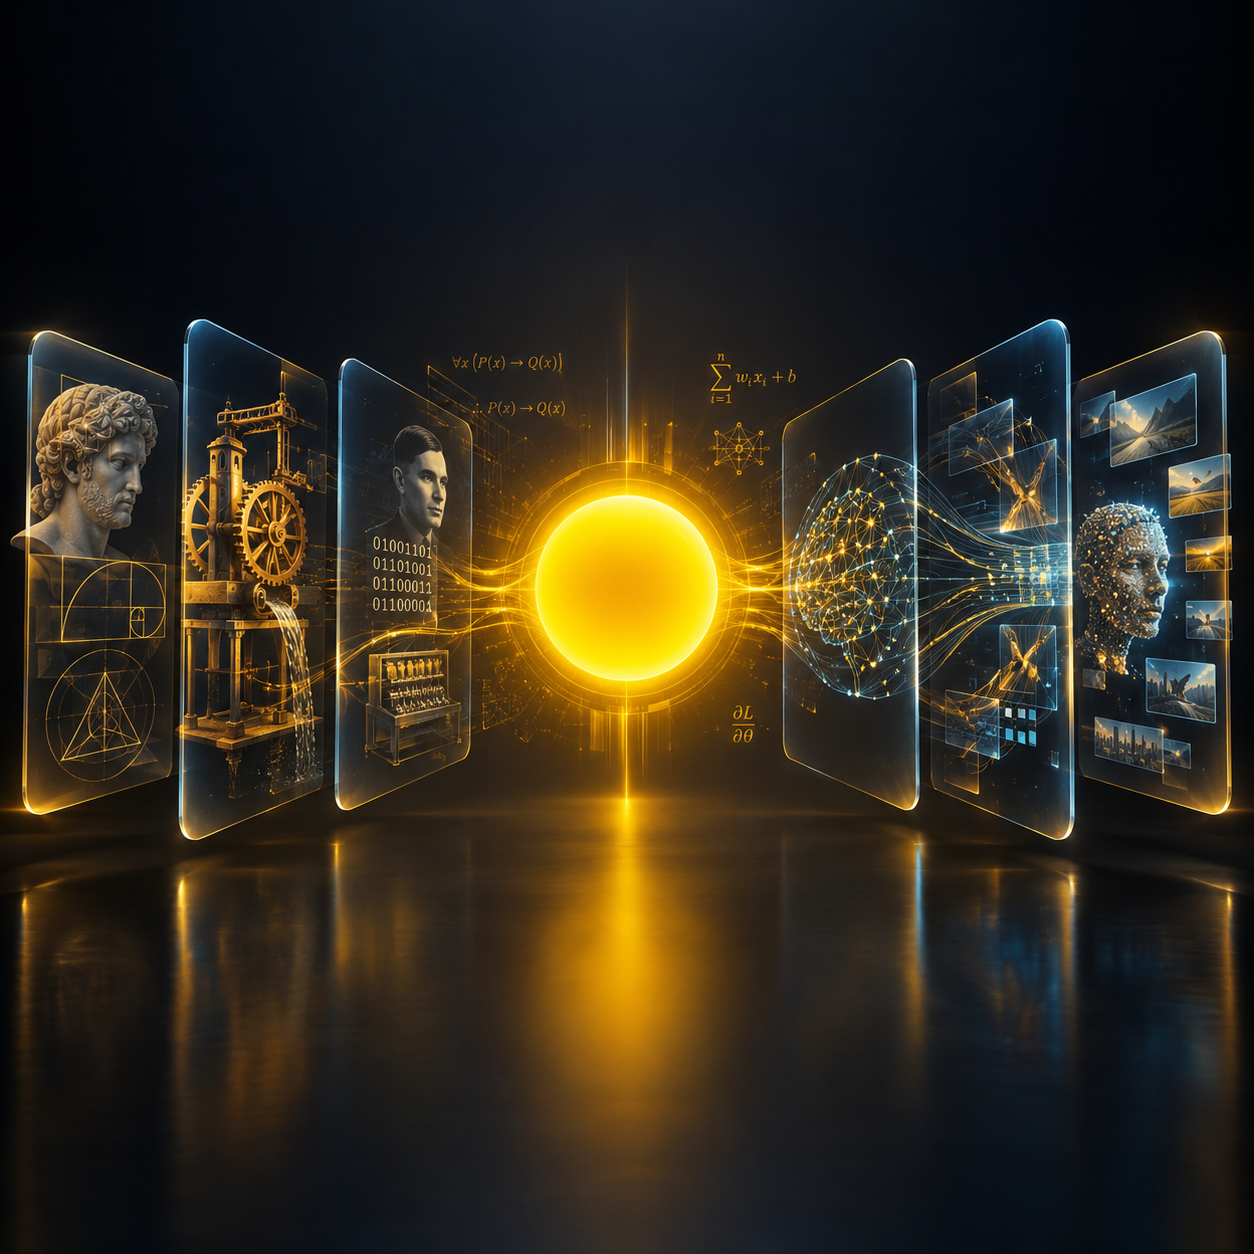
ایدهی ساخت ماشینی که بتواند مانند انسان تفکر کرده و تصمیمگیری نماید، با ظهور رایانههای مدرن آغاز نشده است؛ بلکه ریشههای آن به هزاران سال پیش بازمیگردد. در طول تاریخ بشر، فیلسوفان، اندیشمندان و دانشمندان گوناگونی کوشیدهاند تا به این پرسشهای بنیادی پاسخ دهند که: «ماهیت هوش چیست؟» و «آیا میتوان هوش را بهصورت مصنوعی بازآفرینی کرد؟». این پرسشهای نظری، خشتبنای اندیشههایی شدند که در نهایت به پیدایش هوش مصنوعی (AI) بهعنوان یک حوزه دانش مستقل انجامید.
در یونان باستان، فیلسوفانی چون افلاطون (Plato) و ارسطو (Aristotle) اهمیت ویژهای برای منطق، تفکر ساختاریافته و روشهای دستیابی به معرفت قائل بودند. بهویژه ارسطو، نخستین سیستم منطق صوری (Formal Logic) را پایهگذاری کرد و در آن قوانین قیاس منطقی (Syllogism) را تدوین نمود. این تلاشهای اولیه اگرچه مستقیماً به ساخت هوش مصنوعی نینجامید، اما این اصل بنیادی را استوار ساخت که تفکر انسانی را میتوان از طریق قوانین و اصول مشخص بهصورت نمادین توصیف کرد.
در قرون وسطی و آغاز عصر جدید، ریاضیدانان و فیلسوفان کوشیدند منطق و ریاضیات را بهصورت سیستماتیک توسعه دهند. در قرن هفدهم، گوتفرید ویلهلم لایبنیتس (Gottfried Wilhelm Leibniz) زبان نمادین جهانی را برای بیان منطق و مفاهیم پیشنهاد داد. او بر این باور بود که اگر تمامی اندیشهها به قوانین ریاضی تبدیل شوند، ماشینهای محاسباتی آینده خواهند توانست مسائل پیچیده را از طریق محاسبات ریاضی حل کنند. این ایده اگرچه در آن عصر امکان تحقق عملی نیافت، اما پایهگذار یک چارچوب عقلانی مهم برای هوش مصنوعی شد.
در قرن نوزدهم، پیشرفتهای چشمگیری در مهندسی محاسبات و اتوماسیون به وقوع پیوست. چارلز بابیج (Charles Babbage) «موتور تحلیلی» (Analytical Engine) را طراحی کرد که واجد ویژگیهای اصلی رایانههای مدرن از جمله حافظه (Memory)، واحد پردازش (ALU) و قابلیت برنامهنویسی بود. گرچه این ماشین هرگز بهطور کامل ساخته نشد، اما تاریخنگاران علم آن را نخستین طرح رایانه عمومی میدانند.
در همان دوران، آدا لاولیس (Ada Lovelace) — که از او بهعنوان نخستین برنامهنویس تاریخ یاد میشود — تحلیل بسیار ژرف و آیندهنگرانهای ارائه داد. او پیشبینی کرد که ماشینهای محاسباتی آینده تنها به محاسبه اعداد محدود نخواهند ماند، بلکه قادر خواهند بود موسیقی، تصاویر و انواع دادههای ساختارنیافته را نیز پردازش کنند. این دیدگاه در آن زمان بسیار پیشرو بود و در گسترش افقهای هوش مصنوعی نقش بسزایی ایفا کرد.
در اوایل قرن بیستم، شتاب توسعه منطق صوری و پایههای ریاضی افزایش یافت. کارهای جورج بول (George Boole) در جبر بولی و در ادامه پژوهشهای گوتلوب فرگه (Gottlob Frege)، برتراند راسل (Bertrand Russell) و آلفرد نورث وایتهد (Alfred North Whitehead)، ساختاری استوار برای منطق ریاضی فراهم ساخت. این دستاوردهای ریاضی اثبات کردند که الگوهای معینی از تفکر انسانی را میتوان در قالب قوانین صوری صورتبندی نمود و اجرای آن را به یک ماشین خودکار سپرد.
بزرگترین جهش پارادایمی در این مرحله با کارهای بنیادی الن تورینگ (Alan Turing) رقم خورد. او در سال ۱۹۳۶ در مقاله تاریخی خود با عنوان On Computable Numbers, with an Application to the Entscheidungsproblem، مدل نظری «ماشین تورینگ» (Turing Machine) را معرفی کرد. تورینگ بهصورت ریاضی اثبات نمود که هر فرآیند منطقی، در صورتی که بتوان آن را از طریق یک الگوریتم بهدقت توصیف کرد، توسط یک ماشین تورینگ عمومی قابل اجرا خواهد بود. این مفهوم نظری پایهگذار علوم رایانه و هوش مصنوعی گردید.
پس از جنگ جهانی دوم، ظهور رایانههای الکترونیکی بستر مناسبی را برای تحقق عملی این نظریهها فراهم ساخت. در سال ۱۹۵۰، تورینگ مقاله بنیادین خود را با عنوان Computing Machinery and Intelligence در نشریه Mind منتشر کرد و این پرسش تاریخی را مطرح ساخت: «آیا ماشینها میتوانند فکر کنند؟» ("Can machines think?"). وی همچنین آزمونی کاربردی را برای ارزیابی رفتار هوشمندانه یک سیستم رایانهای پیشنهاد داد که امروزه به «آزمون تورینگ» (Turing Test) معروف است.
تمامی این پیشرفتها — از منطق یونان باستان و فلسفه ریاضی لایبنیتس تا موتور تحلیلی بابیج، چشمانداز محاسباتی لاولیس و نظریههای محاسباتی تورینگ — بستر علمی و فکری استواری را برای پیدایش هوش مصنوعی فراهم آوردند. این مسیر در نهایت در سال ۱۹۵۶ با برگزاری کنفرانس دارتموث (Dartmouth Conference) و رسمیت یافتن هوش مصنوعی بهعنوان یک حوزه علمی مستقل به بار نشست.
اسماعیل جزری و مهندسی اتوماتا پیشین (Al-Jazari and Automata)
قرنها پیش از رسمیت یافتن هوش مصنوعی، تلاشها برای ساخت ابزارهای خودکار و سیستمهای خودگردان، زیرساخت تجربی و مهندسی ارزشمندی را برای رشد بعدی روباتیک و مهندسی مکانیک فراهم ساخت. یکی از برجستهترین پیشگامان این عرصه، بدیعالزمان ابوالعز بن اسماعیل بن رزاز جزری (Ismail al-Jazari، ۱۱۳۶–۱۲۰۶ میلادی) بود. جزری در آمد (دیاربکر امروزی) در شمال کردستان میزیست و نزدیک به پنجاه سال بهعنوان سرپایهگذار و مهندس ارشد در دربار آل ارتق (Artuqids) خدمت کرد.
در سال ۱۲۰۶ میلادی، جزری شاهکار مهندسی خود را با عنوان کتاب فی معرفة الحیل الهندسیة (The Book of Knowledge of Ingenious Mechanical Devices) به پایان رساند. این اثر یکی از مهمترین اسناد تاریخی مهندسی مکانیک به شمار میرود که در آن حدود ۵۰ دستگاه مکانیکی و خودکار همراه با نقشه، تصویر و توضیحات دقیق فنی تشریح شده است. اختراعات او شامل ساعتهای آبی پیچیده، پمپهای هیدرولیکی دوسره (Double-acting Pump)، خدمتکاران خودکار، دستگاههای وضوگیری خودکار و گروههای موسیقی مکانیکی بود که همگی بدون دخالت انسان و از طریق مکانیک سیالات، نیروی گرانش و بادامکها (Cam Mechanism) کار میکردند.
بسیاری از تاریخنگاران فناوری، جزری را یکی از «پدران مهندسی مکانیک و تئوری کنترل اتوماسیون» میدانند. اگرچه ماشینهای جزری واجد هوش مصنوعی به معنای مدرن آن — یعنی دارای قابلیت یادگیری، تصمیمگیری مستقل یا انطباق با محیط — نبودند، اما نوآوریهای مهندسی او نقطهعطفی حیاتی در تاریخ ساخت اتوماتاهای انساننما و سیستمهای خودکار محسوب میشود.
الن تورینگ و آزمون تورینگ (Alan Turing and the Turing Test)
الن ماتیسون تورینگ (۱۹۱۲–۱۹۵۴) بهعنوان یکی از محوریترین بنیانگذاران علوم رایانه و هوش مصنوعی شناخته میشود. پژوهشهای او نه تنها چارچوبی نظری برای محاسبات فراهم ساخت، بلکه پارادایم جدیدی را در سنجش توانایی ماشینها در شبیهسازی هوش انسانی گشود. افزون بر این، تورینگ در طول جنگ جهانی دوم نقشی کلیدی در رمزگشایی ماشین «انیگما» (Enigma) آلمان ایفا کرد که تأثیر تعیینکنندهای بر پیروزی متفقین و توسعه رایانههای مدرن داشت.
مدل ماشین تورینگ و پایههای علم محاسبات
تورینگ در سال ۱۹۳۶ مقاله تاریخی خود را منتشر کرد و مدل ریاضی انتزاعی «ماشین تورینگ» را معرفی نمود.
این مدل یک دستگاه فیزیکی نبود، بلکه ساختاری ریاضی بود که نشان میداد چگونه هر فرآیند منطقی را میتوان به گامهای گسسته و ترتیبی تجزیه کرد. اهمیت این الگوریتم در اثبات قابلیت محاسباتی الگوریتمی بود: یعنی هر مسئلهای که بتوان آن را در قالب الگوریتم بیان کرد، نظریتاً توسط یک ماشین تورینگ عمومی قابل حل خواهد بود. این ایده، سنگبنای تمامی رایانههای مدرن گردید.
«آیا ماشینها میتوانند فکر کنند؟»
در سال ۱۹۵۰، تورینگ در مقاله معروف خود در مجله Mind پرسش بنیادی زیر را مطرح ساخت:
"Can machines think?" («آیا ماشینها میتوانند فکر کنند؟»)
تورینگ بر این باور بود که واژه «تفکر» از نظر فلسفی و معنایی بسیار مبهم است. از این رو پیشنهاد داد که به جای درگیری با این مفهوم انتزاعی، یک آزمون رفتاری عملی برای ارزیابی عملکرد سیستمهای رایانهای به کار گرفته شود.
آزمون تورینگ (The Turing Test)
این آزمون که در اصل «بازی تقلید» (Imitation Game) نامیده میشد، از سه شرکتکننده اصلی تشکیل شده است:
۱. یک انسان (بهعنوان معیار سنجش)؛
۲. یک رایانه یا سیستم هوش مصنوعی (که میکوشد رفتار انسانی را شبیهسازی کند)؛
۳. یک ارزیاب انسانی (داور) که در اتاقی مجزا قرار دارد و در شرایط آزمون کور تصمیمگیری میکند.
ارزیاب تنها از طریق تبادل پیامهای متنی با هر دو طرف به گفتگو میپردازد. اگر در پایان آزمون، داور نتواند با اطمینان ماشین را از انسان تشخیص دهد، ماشین آزمون را با موفقیت پشت سر گذاشته است.
یادداشت اکادمیک: هدف این آزمون اثبات برخورداری ماشین از «آگاهی» یا «احساس» نیست، بلکه تنها معیاری عملی برای ارزیابی میزان توانایی ماشین در شبیهسازی رفتار زبانی و گفتگو در سطح انسان ارائه میدهد.
تأثیر بر سیر تطور هوش مصنوعی
آزمون تورینگ به یکی از تاثیرگذارترین شاخصها در تاریخ هوش مصنوعی بدل شد. این آزمون برای نخستین بار چارچوبی عملیاتی برای ارزیابی سیستمهای هوشمند فراهم آورد. این دیدگاه مسیر پژوهشهای پس از سال ۱۹۵۰ را بهشدت تحت تأثیر قرار داد و محرک اصلی توسعه رباتهای گفتگو (Chatbots)، سیستمهای پرسش و پاسخ و در نهایت مدلهای زبانی بزرگ (LLMs) گردید.
در قرن بیست و یکم و با ظهور مدلهای زبانی پیشرفته، بحث پیرامون آزمون تورینگ بار دیگر به محوری جدی بدل شده است. اگرچه برخی سیستمهای مدرن میتوانند در گفتگوهای کوتاه رفتار کاملاً انسانی بروز دهند، اما اجماع جامعه دانشگاهی بر این است که صرف قبولی در آزمون تورینگ به معنای دستیابی به هوش عمومی مصنوعی (AGI) یا آگاهی نیست؛ چرا که یک سیستم میتواند بدون درک واقعی و تنها از طریق الگویابی آماری، رفتاری شبیه به انسان تولید نماید.
نقدها و محدودیتهای نظری
آزمون تورینگ با وجود وزن تاریخی خود، با نقدهای جدی از سوی دانشمندان مواجه شده است. از جمله جان سرل (John Searle) با ارائه آزمایش فکری «اتاق چینی» (Chinese Room) اثبات کرد که یک سیستم میتواند بدون داشتن هیچگونه درک واقعی از معنا (Semantics)، تنها بر اساس قواعد صوری (Syntax) دست به پردازش نمادها بزند. همچنین علوم شناختی تأکید دارد که هوش انسانی تنها به تعامل زبانی محدود نمیشود، بلکه پیوندی ناگسستنی با ادراک محیطی، تصمیمگیری و تعامل با جهان واقعی دارد.
کنفرانس دارتموث و رسمیت یافتن هوش مصنوعی (The Dartmouth Conference and the Formal Birth of AI)
اکثر تاریخنگاران رایانه و جامعه دانشگاهی، سال ۱۹۵۶ را زمان پیدایش رسمی هوش مصنوعی (Artificial Intelligence, AI) بهعنوان یک رشته علمی مستقل میدانند. در تابستان این سال، همایشی پژوهشی و نوآورانه در کالج دارتموث (Dartmouth College) در ایالت نیوهمپشایر آمریکا برگزار شد که بعدها به «پروژه پژوهشی تابستانی دارتموث در باب هوش مصنوعی» شهرت یافت.
این کنفرانس نخستین تلاش سازمانیافته برای پایهگذاری یک حوزه علمی مستقل بود که اختصاصاً به بررسی نحوه ساخت سیستمهایی با رفتار هوشمندانه میپرداخت.
خاستگاه پروژه و پیشگامان (Origins and Pioneers)
ایده برگزاری این همایش نخستین بار توسط جان مککارتی (John McCarthy) پیشنهاد شد؛ فردی که بعدها به «پدر هوش مصنوعی» معروف گردید. همراه با او، ماروین مینسکی (Marvin Minsky)، ناتانیل روچستر (Nathaniel Rochester) از شرکت IBM و کلود شانون (Claude Shannon) بنیانگذار نظریه اطلاعات (Information Theory)، در نگارش طرح پیشنهادی مشارکت داشتند.
در متن پیشنهادنامه این پروژه، فرضیه علمی محوری زیر آمده بود:
«هر جنبهای از یادگیری یا هر ویژگی دیگری از هوش را میتوان چنان با دقت توصیف کرد که بتوان ماشینی ساخت تا آن را شبیهسازی نماید.»
این عبارت به سنگبنای نظری استواری برای پژوهشگران آن عصر بدل شد؛ زیرا آنان کاملاً باور داشتند که هوش انسانی را میتوان از طریق قوانین، الگوریتمها و قدرت محاسباتی تعریف نمود و سپس توسط رایانه به اجرا درآورد.
پیدایش واژه "Artificial Intelligence" (Birth of the Term "Artificial Intelligence")
یکی از مهمترین و تاریخیترین دستاوردهای کنفرانس دارتموث این بود که جان مککارتی برای نخستین بار اصطلاح «Artificial Intelligence» (هوش مصنوعی) را بهصورت رسمی در سطح آکادمیک به کار برد. پیش از آن، پژوهشهای این حوزه تحت عناوین متفاوتی چون سایبرنتیک (Cybernetics)، نظریه خودکارها (Automata Theory) یا پردازش اطلاعات پیچیده (Complex Information Processing) شناخته میشد.
انتخاب این نام جدید دارای یک دلیل استراتژیک بود؛ زیرا مککارتی میخواست این حوزه را از سایر علوم مجزا ساخته و هویت علمی مستقلی برای آن تعریف کند. از این رو، سال ۱۹۵۶ تنها سال برگزاری یک کنفرانس نبود، بلکه سال ولادت رسمی یک دانش نوپا بود.
اهداف اصلی کنفرانس (Primary Objectives of the Conference)
پژوهشگران حاضر در دارتموث با خوشبینی فراوان پیشبینی میکردند که ظرف چند سال محدود خواهند توانست مسائل اصلی هوش انسانی را حل کنند. مهمترین اهداف آنان عبارت بود از:
۱. ابداع سیستمهای یادگیری خودکار (ماشینی)؛
۲. فهم و پردازش زبان طبیعی (Natural Language Processing, NLP)؛
۳. صورتبندی مکانیسمهای حل مسئله و تصمیمگیری؛
۴. تحلیل صوری تفکر منطقی؛
۵. توسعه قابلیت تشخیص تصاویر و اشیاء؛
۶. ساخت ماشینی که بتواند رفتاری کاملاً همسطح انسان بروز دهد.
اگرچه دانشمندان در آن زمان تصور میکردند این اهداف در آیندهای بسیار نزدیک محقق میشوند، اما تحولات بعدی نشان داد که هوش انسانی بسیار پیچیدهتر و ژرفتر از الگوهای اولیه آنان است.
تأثیر آکادمیک و پشتیبانیهای نهادی (Academic Impact and Institutional Support)
اگرچه کنفرانس دارتموث خود مستقیماً به دستاورد فنی بزرگی نینجامید، اما تأثیر آن بر سمتوسوی علوم رایانه بینظیر بود. پس از این رویداد، دانشگاههای بزرگ جهان دست به تأسیس آزمایشگاههای اختصاصی هوش مصنوعی زدند؛ از جمله دانشگاههای MIT، Stanford و Carnegie Mellon.
همزمان، دولت آمریکا و نهادهای فدرال نظیر DARPA بودجههای پژوهشی هنگفتی را برای پشتیبانی از این حوزه جدید اختصاص دادند. این حمایتهای مالی به محرک اصلی برای توسعه نخستین برنامههای هوشمند و پیشبرد دانش یادگیری ماشین بدل گردید.
دستاوردهای نخستین و پیشگامانه: دهه ۱۹۵۰–۱۹۶۰ (Early Breakthroughs: 1950s–1960s)
در نیمه دوم دهه ۱۹۵۰ و اوایل دهه ۱۹۶۰، چندین پروژه راهگشا پدید آمدند که مهمترین آنها عبارت بودند از:
برنامه Logic Theorist (۱۹۵۶): توسط الن نیوئل (Allen Newell) و هربرت سایمون (Herbert A. Simon) توسعه یافت و بهعنوان نخستین برنامه هوش مصنوعی در تاریخ شناخته میشود که توانایی اثبات قضایای منطق نمادین را داشت.
سیستم General Problem Solver (GPS): تلاشی پیشگامانه برای ایجاد یک الگوی عمومی جهت حل مسائل منطقی.
زبان برنامهنویسی LISP (۱۹۵۸): توسط خود جان مککارتی ابداع شد و برای چندین دهه بهعنوان زبان اصلی و پایه تمامی پژوهشهای هوش مصنوعی در جهان به کار رفت.
این دستاوردها، با وجود محدودیتهایشان، اثبات کردند که رایانهها میتوانند وظایف تفکر منطقی را با موفقیت به انجام برسانند.
زمستانهای هوش مصنوعی (AI Winters)
پس از آغاز پرقدرت هوش مصنوعی در دهه ۱۹۵۰ و اوایل ۱۹۶۰، بسیاری از پژوهشگران و نهادهای سرمایهگذار بسیار خوشبین بودند که رایانهها ظرف چند سال خواهند توانست اکثر وظایف هوشمندانه انسان را بر عهده بگیرند. اما این امیدها با توانایی واقعی و عملی فناوری آن عصر همخوانی نداشت.
نتیجه این شکاف بزرگ میان انتظارات و واقعیت، افتهای دورهای شدید در بودجههای پژوهشی، باور عمومی و فعالیتهای علمی بود. این دورههای رکود در تاریخ فناوری به نام «زمستانهای هوش مصنوعی» (AI Winters) شناخته میشوند.
اصطلاح «زمستان هوش مصنوعی» به چرخهای تاریخی اشاره دارد که در آن پشتیبانی مالی و انتظارات عمومی به شدت سقوط میکرد؛ زیرا دستاوردهای عملی به سطح پیشبینیهای بزرگی که پژوهشگران و شرکتها وعده داده بودند نمیرسید. این زمستانها از مهمترین نقاط عطف تاریخ هوش مصنوعی بودند، چرا که این رشته را وادار ساختند تا پارادایمها و روششناسیهای نظری خود را بازارزیابی کند.
نخستین زمستان هوش مصنوعی: دهه ۱۹۷۰ (The First AI Winter: 1970s)
نخستین زمستان این حوزه در اواخر دهه ۱۹۶۰ و اوایل دهه ۱۹۷۰ آغاز شد. در آن دوران، اگرچه نخستین برنامههای هوشمند نظیر Logic Theorist، GPS و ELIZA توجه رسانهها و محافل علمی را جلب کرده بودند، اما تواناییهایشان بسیار محدود بود. اکثر این سیستمها تنها در یک محیط آزمایشگاهی ساده کار میکردند و در مواجهه با مسائل پیچیده جهان واقعی ناکارآمد بودند.
کتاب Perceptrons (۱۹۶۹): در این سال، ماروین مینسکی (Marvin Minsky) و سیمور پپرت (Seymour Papert) کتاب معروف Perceptrons را منتشر کردند که در آن محدودیتهای ریاضی شبکههای عصبی مصنوعی تکلایه را روشن ساختند. اگرچه نقدهای آنان از نظر علمی کاملاً درست بود، اما بسیاری از سرمایهگذاران چنین برداشت کردند که شبکههای عصبی هیچ آیندهای ندارند؛ این مسئله موجب توقف پژوهشها در این زمینه برای نزدیک به دو دهه شد.
گزارش لایتهیل (۱۹۷۳): در این سال، دولت بریتانیا گزارشی استراتژیک با عنوان Lighthill Report منتشر کرد. این گزارش توسط ریاضیدان برجسته، سر جیمز لایتهیل (Sir James Lighthill) تهیه شده بود که در آن به تندی به محدودیتهای هوش مصنوعی و فقدان دستاوردهای عملی اشاره شده بود. پس از انتشار این گزارش، بودجه اکثر پروژههای این حوزه در بریتانیا قطع شد که تأثیر منفی بزرگی در سطح بینالمللی نیز بر جای گذاشت.
بازگشت امیدهای تازه: دهه ۱۹۸۰ (The Revival of Hope: 1980s)
در دهه ۱۹۸۰، هوش مصنوعی بهویژه به دلیل موفقیت تجاری سیستمهای خبره (Expert Systems) بار دیگر توجه شرکتها و دولتها را جلب کرد. این سیستمها دانش و تجربه متخصصان را در یک حوزه مشخص گردآوری کرده و برای تصمیمگیری و حل مسائل به کار میبستند. شرکتهای غولپیکری چون Digital Equipment Corporation و IBM سرمایهگذاریهای عظیمی در این زمینه انجام دادند.
در همان زمان، دولت ژاپن پروژه ملی و بزرگ خود را با عنوان «سیستمهای رایانهای نسل پنجم» (Fifth Generation Computer Systems, FGCS) آغاز کرد که هدف آن ساخت رایانههای فوقهوشمند برای حل مسائل بسیار پیچیده بود. این گامها موج تازهای از امید و گرمی را برای آینده هوش مصنوعی ایجاد کرد.
دومین زمستان هوش مصنوعی: اواخر دهه ۱۹۸۰ و اوایل ۱۹۹۰ (The Second AI Winter: Late 1980s–Early 1990s)
بهرغم خوشبینیهای اولیه، در اواخر دهه ۱۹۸۰ هوش مصنوعی بار دیگر با دیواری محکم از موانع فنی و مهندسی مواجه گردید. مشخص شد که سیستمهای خبره (Expert Systems) هزینه ساخت و نگهداری بسیار بالایی دارند، بهروزرسانی پایگاه دانش (Knowledge Base) آنها فوقالعاده دشوار است و در محیطهای پویا و متغیر از انعطافپذیری و قدرت انطباقپذیری بسیار پایینی برخوردارند.
همزمان با این چالش، بازار رایانههای شخصی (Personal Computers, PCs) با سرعتی شگفتآور رشد کرد. بسیاری از سازمانها و شرکتها به سوی راهکارهای سختافزاری و نرمافزاری ارزانتر حرکت کردند که نیازی به سختافزارهای گرانقیمت و اختصاصی هوش مصنوعی نداشت. در نتیجه، بسیاری از شرکتهای تجاری این حوزه ورشکست شدند و بودجههای پژوهشی بار دیگر سقوط کرد. این دوره در تاریخ فناوری به عنوان «دومین زمستان هوش مصنوعی» به ثبت رسید.
دلایل اصلی پیدایش زمستانهای هوش مصنوعی (Key Causes of AI Winters)
مجموعهای از عوامل بنیادی و ساختاری دست به دست هم دادند تا این دورههای رکود ایجاد شوند که مهمترین آنها عبارتاند از:
۱. پیشبینیهای اغراقآمیز و خوشبینیهای غیرواقعی: وعدههای شتابزده درباره دستیابی به هوش عمومی مصنوعی (AGI) در کوتاهمدت.
۲. محدودیت سختافزاری و توان محاسباتی: سرعت پایین و حافظه محدود رایانههای آن عصر در مقایسه با حجم و پیچیدگی وظایف.
۳. فقدان دادههای کافی: عدم دسترسی به دادههای حجیم و باکیفیت برای آموزش سیستمها.
۴. محدودیت الگوریتمهای اولیه: فقدان الگوریتمهای پیشرفته برای استخراج خودکار ویژگیهای سطح بالا.
۵. شکاف میان آزمایشگاه و واقعیت: تفاوت عمیق میان عملکرد سیستم در یک محیط کنترلشده آزمایشگاهی در مقایسه با پیچیدگیهای جهان واقعی.
۶. دلسردی سرمایهگذاران: قطع بودجه از سوی دولتها و شرکتهای بزرگ پس از برآورده نشدن وعدههای بزرگ اولیه.
پیدایش یادگیری ماشین (The Rise of Machine Learning)
پس از عبور از زمستانهای هوش مصنوعی، پژوهشگران به این واقعیت دست یافتند که پارادایم کلاسیک اولیه — که بیشتر بر سیستمهای مبتنی بر قانون (Rule-Based Systems) و کدنویسی دستی توسط انسان متکی بود — دارای حدود نظری معینی است. در اکثر مسائل جهان واقعی، نوشتن تمام قوانین و تصمیمها توسط انسان کاری غیرممکن بود؛ زیرا محیط، شرایط و جریان دادهها همواره در حال تغییر بودند.
از این رو، رویکردی نو و انقلابی در پژوهشها شکل گرفت که به یادگیری ماشین (Machine Learning, ML) معروف شد. در این الگوی جدید، رایانهها دیگر منتظر دستورات صریح برنامهنویس نمیمانند، بلکه خود مستقیماً از طریق دادهها، الگوها و روابط را میآموزند و وظایف را به انجام میرسانند.
جهش سختافزاری و توان محاسباتی (Hardware Advances and Computational Growth)
پیشرفت یادگیری ماشین تنها به ابداع الگوریتمهای جدید محدود نمیشد، بلکه جهش در سختافزارهای رایانهای نقش موتور محرک را ایفا کرد. در دهه ۱۹۹۰ و اوایل ۲۰۰۰، توسعه واحدهای پردازش مرکزی (CPUs) توسط شرکتهای غولپیکری چون Intel و AMD، سرعت پردازش را به شکل چشمگیری افزایش داد. این جهش فناوری راه را برای آزمودن مدلهای پیچیدهتر و تحلیل حجم بسیار بیشتری از دادهها هموار ساخت.
مفهوم و تعریف یادگیری ماشین (Concept and Definition of Machine Learning)
یادگیری ماشین شاخهای محوری از هوش مصنوعی است که هدف آن ساخت سیستمها و نرمافزارهایی است که میتوانند بهصورت خودکار از دادهها بیاموزند، الگوهای پنهان را شناسایی کنند و پیشبینیها یا تصمیمهای دقیق بگیرند؛ بدون آنکه نیاز باشد برنامهنویس تمامی قوانین را بهطور صریح و گامبهگام مشخص کند.
یکی از کلاسیکترین و معروفترین تعاریف این حوزه در سال ۱۹۵۹ توسط دانشمند پیشگام، آرتور ساموئل (Arthur Samuel) ارائه شد:
«یادگیری ماشین زمینهای از پژوهشهای رایانهای است که توانایی یادگیری را به ماشینها میبخشد، بدون آنکه بهطور صریح برای آن وظیفه برنامهنویسی شده باشند.»
عوامل اصلی گسترش یادگیری ماشین (Drivers of Machine Learning Adoption)
در اواخر دهه ۱۹۸۰ و بهویژه در طول دهه ۱۹۹۰، چند تحول بنیادی موجب رشد سریع یادگیری ماشین شدند:
انفجار اطلاعات دیجیتال: شکلگیری نخستین مجموعهدادههای استاندارد و بزرگ (Datasets).
ارتقای سختافزارها: افزایش سرعت پردازش و کاهش هزینه ذخیرهسازی دادهها.
پیشرفت علوم پایه: ادغام ریاضیات آماری، نظریه احتمال (Probability Theory) و نظریه بهینهسازی در علوم رایانه.
نیاز بازار و صنعت: تقاضای روزافزون شرکتها برای سیستمهای پیشبینی، دستهبندی دادهها و تشخیص تصویر و صدا.
این عوامل موجب شدند دانشمندان به جای نوشتن هزاران سطر کد و قانون سخت، مدلهای آماری انعطافپذیری بسازند که خود در میان دادهها به دنبال پاسخ بهینه بگردند.
انواع اصلی یادگیری ماشین (Major Paradigms of Machine Learning)
تکنیکهای یادگیری ماشین در سطح آکادمیک و مهندسی بهطور کلی به سه پارادایم اصلی تقسیم میشوند:
۱. یادگیری نظارتشده (Supervised Learning): در این روش، مدل بر روی دادههایی آموزش میبیند که دارای برچسبهای مشخص و پاسخهای صحیح (Labels) هستند. هدف اصلی این است که مدل رابطه میان ورودی و خروجی را بیاموزد تا بتواند برای دادههای کاملاً جدید، پاسخ درست را پیشبینی کند.
کاربردهای نمادین: پیشبینی قیمت مسکن، تشخیص و فیلتر اسپم در ایمیل، و تشخیص بیماریها از روی تصاویر پزشکی.
۲. یادگیری نظارتنشده (Unsupervised Learning): در این الگوی آموزشی، دادههای ورودی فاقد هرگونه برچسب یا پاسخ پیشفرض هستند. مدل میکوشد ساختارها، الگوهای درونی و خوشهبندیهای پنهان (Clusters) موجود در دادهها را بهطور مستقل کشف کند.
کاربردهای نمادین: بخشبندی مشتریان بر اساس رفتار (Customer Segmentation)، کشف ناهنجاریها و رفتارهای مشکوک (Anomaly Detection)، و کاهش ابعاد دادههای پیچیده (Dimensionality Reduction).
۳. یادگیری تقویتی (Reinforcement Learning): در این روش، سیستم (که عامل یا Agent نامیده میشود) از طریق آزمون و خطا (Trial and Error) در یک محیط پویا میآموزد. اگر رفتار درستی انجام دهد پاداش (Reward) و اگر دچار خطا شود جریمه (Penalty) دریافت میکند. با مرور زمان، عامل بهترین استراتژی را برای بیشینهسازی پاداش کلی تدوین مینماید.
کاربردهای نمادین: بازیهای پیچیده رایانهای (مانند شطرنج و گو)، سیستمهای رباتیک، توسعه خودروهای خودران، و مدیریت خودکار شبکهها.
تکامل الگوریتمها و بازگشت شبکههای عصبی (Algorithmic Evolution and Resurgence of Neural Networks)
در دهههای ۱۹۹۰ و ۲۰۰۰، مجموعهای از الگوریتمهای آماری پیشرفته به کمال رسیدند که پایههای یادگیری ماشین مدرن را شکل دادند؛ از جمله درختهای تصمیم (Decision Trees)، جنگلهای تصادفی (Random Forests)، ماشینهای بردار پشتیبان (Support Vector Machines, SVM)، نایو بیس (Naïve Bayes) و k-نزدیکترین همسایه (k-Nearest Neighbors, k-NN). این روشها در زمینههای اقتصاد، پزشکی و پردازش زبان طبیعی به موفقیتهای کاربردی بزرگی دست یافتند.
همزمان، اگرچه شبکههای عصبی مصنوعی پس از نخستین زمستان هوش مصنوعی به حاشیه رفته بودند، اما پژوهشهای مداوم دانشمندانی چون جفری هینتون (Geoffrey Hinton)، دیوید روملهارت (David Rumelhart) و رونالد ویلیامز در دهههای ۱۹۸۰ و ۱۹۹۰ بر روی الگوریتم انتشار به عقب (Backpropagation)، توجه جامعه علمی را بار دیگر به سوی شبکههای عصبی جلب کرد. الگوریتم پسانتشار روشی ریاضی و فوقالعاده کارآمد برای آموزش شبکههای عصبی چندلایه فراهم ساخت که بعدها به سنگبنای انقلاب یادگیری عمیق (Deep Learning) بدل شد.
مفهوم «Big Data» و ظهور تراشههای GPU (Big Data and GPU Acceleration)
در آغاز قرن بیست و یکم، با همهگیری اینترنت، شبکههای اجتماعی، تلفنهای هوشمند و خدمات دیجیتال، حجم دادههای تولیدشده در جهان به سطحی بیسابقه رسید و عنوان دادههای عظیم (Big Data) را به خود گرفت.
از آنجا که دقت و توانمندی مدلهای یادگیری ماشین بهشدت به دادههای حجیم و باکیفیت وابسته است، ظهور Big Data به سوخت اصلی برای موفقیت این حوزه بدل شد. همزمان، تغییر پارادایم پردازشی از واحدهای پردازش مرکزی (CPU) به واحدهای پردازش گرافیکی (GPU) و توسعه تکنیکهای پردازش موازی (Parallel Computing)، زمان آموزش مدلهای عظیم را از چندین ماه به چند روز یا حتی چند ساعت کاهش داد.
تأثیر استراتژیک یادگیری ماشین بر آینده فناوری (Strategic Impact of ML)
ظهور یادگیری ماشین، نقشه راه و فلسفه پژوهشهای هوش مصنوعی را بهکلی تغییر داد. این تحول بنیادین موجب موفقیت بسیاری از فناوریهایی شد که امروزه در زندگی روزمره از آنها استفاده میکنیم؛ از جمله:
سیستمهای پیشنهاددهنده اختصاصی: مانند الگوریتمهای پیشنهاد فیلم و موسیقی در Netflix و Spotify؛
ترجمه زبانی آنی: سیستمهای پردازش زبان طبیعی چندزبانه؛
بینایی ماشین و تشخیص صوت: فناوریهای شناسایی چهره، تصویر و زیستسنجی (Biometric)؛
پزشکی دیجیتال: تشخیص دقیق و زودهنگام بیماریهای صعبالعلاج؛
هوش تجاری و امنیت سایبری: تحلیل خودکار ریسک، اعتبارپذیری و فیلترینگ اسپم.
مهمتر از همه، یادگیری ماشین به عنوان یک پل استوار عمل کرد که راه را برای پیدایش یادگیری عمیق (Deep Learning) و هوش مصنوعی مولد (Generative AI) هموار ساخت؛ فناوریهایی که امروزه در قله پیشرفت فناوری جهان قرار دارند.
انقلاب یادگیری عمیق: بزرگترین جهش پارادایمی هوش مصنوعی (The Deep Learning Revolution)
یادگیری عمیق (Deep Learning) یکی از مهمترین و تحولآفرینترین نقاط عطف در تاریخ هوش مصنوعی به شمار میرود. اگرچه پایههای نظری شبکههای عصبی مصنوعی (ANNs) در دهههای ۱۹۴۰ و ۱۹۵۰ گذاشته شده بود، اما برای چندین دهه، محدودیت سختافزاری، فقدان داده و پیچیدگیهای ریاضی آموزش شبکههای عمیق، مانع از رشد این حوزه میشد.
در آغاز قرن بیست و یکم، سه عامل محوری به یک همگرایی تاریخی رسیدند: انفجار دادههای دیجیتال (Big Data)، توان محاسباتی موازی تراشههای گرافیکی (GPUs) و ابداع الگوریتمهای جدید آموزش. پیوند این سه عنصر، یادگیری عمیق را به موتور اصلی پیشرفتهای هوش مصنوعی در جهان بدل ساخت.
تغییر پارادایم سختافزار: انتقال از CPU به GPU
یکی از کلیدهای اصلی انقلاب یادگیری عمیق، انتقال بار محاسباتی مدلها از واحدهای پردازش مرکزی (CPU) به واحدهای پردازش گرافیکی (GPU) بود. تراشههای GPU در اصل برای بازیهای رایانهای و رندرینگ گرافیکی سهبعدی طراحی شده بودند، اما پژوهشگران دریافتند که این تراشهها میتوانند هزاران محاسبه ماتریسی را بهصورت همزمان و موازی انجام دهند — دقیقاً همان نیازی که آموزش شبکههای عصبی عمیق به آن وابسته بود.
شرکت NVIDIA در سال ۲۰۰۶ با عرضه معماری CUDA گامی انقلابی برداشت. این پلتفرم به دانشمندان اجازه داد تا از توان محاسباتی GPU مستقیماً برای محاسبات سنگین علمی و مدلهای هوش مصنوعی استفاده کنند. این تحول سختافزاری بستر مناسبی را برای پیروزی تاریخی مدل AlexNet در سال ۲۰۱۲ و آغاز رسمی انقلاب یادگیری عمیق فراهم ساخت.
اصول و معماری یادگیری عمیق (Principles and Architecture of Deep Learning)
یادگیری عمیق شاخهای پیشرفته از یادگیری ماشین است که بر شبکههای عصبی عمیق (Deep Neural Networks, DNNs) متکی است. این شبکهها از لایههای پنهان متعددی (Hidden Layers) تشکیل شدهاند که هر لایه سطح جدیدی از ویژگیهای انتزاعی را از دادهها فرامیگیرد.
برای نمونه، در یک سیستم بینایی ماشین جهت تشخیص اشیاء:
لایههای اولیه: تنها خطوط، زوایا و لبههای اولیه را شناسایی میکنند؛
لایههای میانجی: اشکال و بافتهای پیچیدهتر را ترکیب مینمایند؛
لایههای والاتر: بازنمایی کامل موضوع (مانند چهره انسان یا خودرو) را انجام میدهند.
تفاوت روششناختی بنیادی میان یادگیری ماشین کلاسیک و یادگیری عمیق در این است:
رویکرد کلاسیک: نیازمند آن بود که متخصصان انسانی ویژگیهای دادهها (Features) را بهصورت دستی استخراج و تعریف کنند؛
رویکرد یادگیری عمیق: بر پایه یادگیری سرراست (End-to-End) عمل میکند؛ یعنی مدل، ویژگیهای لایهای را بهطور کاملاً خودکار مستقیم از دادههای خام (Raw Data) استخراج کرده و فرامیگیرد.
همین قابلیت خیرهکننده بازنمایی خودکار موجب شد یادگیری عمیق در حوزههای پیچیدهای چون بینایی ماشین، تشخیص گفتار و پردازش زبان طبیعی به موفقیتهای بینظیری دست یابد.
بازگشت پرقدرت شبکههای عصبی (Resurgence of Neural Networks)
در دهه ۱۹۸۰، دانشمندانی چون جفری هینتون (Geoffrey Hinton)، دیوید روملهارت (David Rumelhart) و رونالد ویلیامز الگوریتم انتشار به عقب (Backpropagation) را توسعه داده و همهگیر ساختند. این روش، راهکاری ریاضی و فوقالعاده کارآمد برای آموزش شبکههای عصبی چندلایه بود. اما در آن دوران، سرعت رایانهها و حجم دادههای دسترسپذیر هنوز برای بهکارگیری شبکههای بسیار بزرگ در عمل کافی نبود.
در دهه ۲۰۰۰، با افزایش توان محاسباتی تراشههای GPU و دسترسپذیر شدن مجموعهدادههای بزرگ در سراسر اینترنت، پژوهشگران بار دیگر به سوی این رویکرد بازگشتند. بدین ترتیب پارامترهای شبکههای عصبی عمیق با موفقیت آموزش داده شد و این امر پایههای استواری را برای انقلاب یادگیری عمیق (Deep Learning) بنا نهاد.
پروژه ImageNet: انفجار تاریخی سال ۲۰۱۲ (The ImageNet Landmark: 2012)
اکثر تاریخنگاران هوش مصنوعی، سال ۲۰۱۲ را زمان آغاز رسمی انقلاب یادگیری عمیق میدانند. در این سال، الکس کریژفسکی (Alex Krizhevsky)، ایلیا سوتسکور (Ilya Sutskever) و جفری هینتون (Geoffrey Hinton) یک شبکه عصبی عمیق با نام AlexNet طراحی کرده و در مسابقه بینالمللی ImageNet شرکت دادند.
AlexNet با بهرهگیری از معماری شبکه عصبی پیچشی (Convolutional Neural Network - CNN) و توان پردازش موازی تراشههای GPU، نرخ خطا در تشخیص تصاویر را به شکلی حیرتآور کاهش داد. این مدل، تمامی رقبای مبتنی بر روشهای سنتی را با فاصلهای فاحش پشت سر گذاشت. این پیروزی تاریخی اثبات کرد که یادگیری عمیق در مسائل پیچیده جهان واقعی بسیار توانمندتر از رویکردهای کلاسیک است؛ در نتیجه، دانشگاههای جهان، غولهای فناوری و سرمایهگذاران، سرمایههای عظیمی را به این حوزه گسیل داشتند.
تکامل معماری مدلهای یادگیری عمیق (Evolution of Deep Learning Architectures)
پس از موفقیت بزرگ AlexNet، معماریهای گوناگونی از شبکههای عصبی تکامل یافتند که هر یک تحولی بنیادین در حوزهای خاص ایجاد نمودند:
شبکههای عصبی پیچشی (CNNs): اختصاصاً برای بینایی ماشین، تشخیص اشیاء، تحلیل ویدیو و تصویربرداری پزشکی؛
شبکههای عصبی بازگشتی (RNNs): جهت پردازش دادههای ترتیبی (Sequential) نظیر متن، گفتار و سریهای زمانی؛
شبکههای LSTM (Long Short-Term Memory): برای درک زنجیرههای طولانی داده و جملات بدون فراموشی بافت اولیه؛
شبکههای ترنسفورمر (Transformer Networks): در سال ۲۰۱۷ توسط گوگل معرفی شدند و مکانیسم «خودتوجهی» (Self-Attention) را ارائه دادند. این معماری سنگبنای اصلی مدلهای زبانی بزرگ (LLMs) و هوش مصنوعی مولد (Generative AI) کنونی گردید.
پیامدهای کاربردی و اجتماعی یادگیری عمیق (Practical Impact of Deep Learning)
یادگیری عمیق تحولاتی بنیادین در حوزههای حساس و کلیدی ایجاد کرده است:
بینایی ماشین: تشخیص چهره در تلفنهای هوشمند، تحلیل تصاویر پزشکی و هدایت خودروهای خودران؛
پردازش زبان طبیعی: ترجمه چندزبانه آنی، خلاصهسازی متون طولانی و رباتهای گفتگو (مانند ChatGPT)؛
تشخیص گفتار: عملکرد دستیارهای صوتی هوشمند و فناوریهای تبدیل گفتار به متن؛
بهداشت و زیستپزشکی: تشخیص زودهنگام سرطان، تحلیل دادههای ژنتیکی (DNA) و کشف مولکولهای دارویی جدید؛
صنعت و تجارت: پیشبینی تقاضای بازار، کنترل کیفیت خودکار و سیستمهای پیشنهاد خریدار.
محدودیتها و چالشهای یادگیری عمیق (Limitations and Challenges)
بهرغم تمامی این دستاوردهای بزرگ، یادگیری عمیق دارای محدودیتهای جدی است:
وابستگی شدید به داده و هزینه محاسباتی بالا: آموزش این مدلها نیازمند حجم عظیمی از دادهها و زیرساختهای سختافزاری بسیار گرانقیمت و پرمصرف است؛
مسئله «جعبه سیاه» (Black Box Problem): اکثر مدلهای عمیق به دلیل ساختار پیچیده درونی، شفاف نیستند. مدل پاسخ درستی میدهد، اما تحلیل منطق درونی پشت این تصمیم بسیار دشوار است. این ناپیدایی، چالشهای بزرگی در زمینه اعتماد و پاسخگویی در حوزههای حیاتی چون پزشکی، حقوق و مالیت ایجاد کرده است.
هوش مصنوعی مولد (Generative AI) و ChatGPT: عصر نوینی از تولید محتوا
در اواخر دهه ۲۰۱۰ و اوایل دهه ۲۰۲۰، هوش مصنوعی وارد مرحلهای کاملاً جدید و شگفتآور شد که به هوش مصنوعی مولد (Generative AI) معروف است. تفاوت بنیادی این دوره با عصرهای پیشین در این است که سیستمها دیگر تنها ابزارهای تحلیل یا دستهبندی داده نیستند، بلکه خود میتوانند محتواهای کاملاً جدید و اصیل نظیر متن، تصویر، صدا، ویدیو و کد برنامهنویسی تولید کنند.
هوش مصنوعی مولد چیست؟ (What is Generative AI?)
هوش مصنوعی مولد شاخهای پیشرفته است که در آن مدلها برای درک الگوها، توزیعهای احتمالی و روابط پنهان در مجموعهدادههای عظیم آموزش میبینند. سپس بر اساس آموختههای خود، در پاسخ به دستورات ورودی (Prompts)، محتوای جدید خلق میکنند.
زیرساخت سختافزاری و جهش مدلهای زبانی بزرگ (LLMs)
توسعه مدلهای زبانی بزرگ و هوش مصنوعی مولد بدون جهش در سختافزارها غیرممکن بود. آموزش این مدلهای غولپیکر نیازمند هزاران تراشه GPU است که بهصورت موازی با یکدیگر کار کنند.
امروزه تراشههای پیشرفته شرکت NVIDIA (مانند A100 و H100) ستون فقرات زیرساخت هوش مصنوعی جهان محسوب میشوند. معماری CUDA این شرکت به پژوهشگران اجازه داد تا از توان GPU برای محاسبات سنگین علمی و مدلهای AI استفاده کنند.
ظهور مدلهای زبانی بزرگ و توانمندیهای آنها (Large Language Models - LLMs)
بر پایه معماری ترنسفورمر (Transformer)، مدلهای زبانی بزرگ (LLMs) تکامل یافتند. این مدلها بر روی صدها میلیارد واژه و متن آموزش میبینند تا بتوانند بافتهای پیچیده زبان طبیعی و مفاهیم انتزاعی انسان را درک کنند.
مدلهای زبانی بزرگ میتوانند این وظایف را با موفقیت انجام دهند:
پاسخگویی منطقی به پرسشها؛
نگارش متون جدید و خلاصهسازی متون طولانی؛
ترجمه روان و خودکار میان زبانهای مختلف؛
تولید، اشکالزدایی (Debugging) و تحلیل کدهای برنامهنویسی؛
اصلاح خطاهای زبانی و دستوری؛
همیاری در پژوهشهای علمی و حل مسائل پیچیده.
مدل ChatGPT: عصری نو در گفتگوی انسان و ماشین
ChatGPT معروفترین و پرکاربردترین نمود هوش مصنوعی مولد در جهان است. این سیستم توسط شرکت OpenAI توسعه یافته و بر پایه سلسلهمدلهای GPT (Generative Pre-trained Transformer) کار میکند.
هنگامی که نخستین نسخه عمومی ChatGPT در ۳۰ نوامبر ۲۰۲۲ عرضه شد، ظرف چند روز میلیونها کاربر را در سراسر جهان به خود جلب کرد. این استقبال بینظیر نشان داد که جوامع بشری آمادهاند تا هوش مصنوعی را بهعنوان ابزاری روزمره برای یادگیری، نگارش، کدنویسی و ترجمه به کار گیرند.
راز موفقیت ChatGPT: افزون بر پیشآموزش بر روی دادههای عظیم، این مدل از تکنیک یادگیری تقویتی از طریق بازخورد انسانی (Reinforcement Learning from Human Feedback - RLHF) بهره میبرد. این تکنیک موجب شده پاسخها کاملاً همراستا با قصد انسان، ساختاریافته و منطبق با لحن طبیعی گفتگو ارائه شوند.
کاربردهای چندبعدی هوش مصنوعی مولد (Applications of Generative AI)
هوش مصنوعی مولد حوزههای کلیدی را متحول ساخته است:
آموزش: تهیه خلاصه دروس، توضیح مفاهیم سخت علمی و ایفای نقش معلم اختصاصی؛
بهداشت و درمان: کمک به پزشکان در نگارش سریع گزارشهای بالینی و تحلیل دادههای بیماران؛
مهندسی نرمافزار: یاریرسانی به توسعهدهندگان در کدنویسی، دیباگ و تحلیل معماری کد؛
رسانههای دیجیتال: تنظیم پیشنویس اخبار، تولید محتوا و هنر دیجیتال؛
تجارت و بازاریابی: تولید متنهای تبلیغاتی، خدمات مشتریان خودکار و تحلیل استراتژیهای بازار؛
هنر و طراحی: خلق تصاویر خلاقانه، موسیقی، ویدیو و طرحهای بصری.
کتابشناسی و منابع علمی (Academic Bibliography)
Russell, S., & Norvig, P. (2021). Artificial Intelligence: A Modern Approach (4th ed.). Pearson.
Turing, A. M. (1936). On Computable Numbers, with an Application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, 2(42), 230–265.
Turing, A. M. (1950). Computing Machinery and Intelligence. Mind, 59(236), 433–460.
McCorduck, P. (2004). Machines Who Think: A Personal Inquiry into the History and Prospects of Artificial Intelligence (2nd ed.). A K Peters.
Nilsson, N. J. (2010). The Quest for Artificial Intelligence: A History of Ideas and Achievements. Cambridge University Press.
al-Jazarī, I. (1974). The Book of Knowledge of Ingenious Mechanical Devices (D. R. Hill, Trans.). D. Reidel Publishing Company.
Hill, D. R. (1998). Mechanical Engineering in the Medieval Near East. Scientific American, 264(5), 100–105.
Hill, D. R. (1991). Islamic Science and Engineering. Edinburgh University Press.
Encyclopaedia Britannica. al-Jazari.
Ceccarelli, M. (2004). Distinguished Figures in Mechanism and Machine Science. Springer.